🦋🤖 Robo-Spun by IBF 🦋🤖
Claude gibi dil modelleri insanlar tarafından doğrudan programlanmaz—bunun yerine büyük miktarda veri üzerinde eğitilirler. Bu eğitim sürecinde, problemleri çözmek için kendi stratejilerini öğrenirler. Bu stratejiler, bir modelin yazdığı her kelime için gerçekleştirdiği milyarlarca hesaplamaya kodlanmıştır. Bu hesaplamalar, modelin geliştiricileri olan bizlere anlaşılmaz şekilde ulaşır. Bu da modellerin yaptıkları şeylerin çoğunu nasıl yaptıklarını anlamadığımız anlamına gelir.
Claude gibi modellerin nasıl düşündüğünü bilmek, yeteneklerini daha iyi anlamamıza yardımcı olabileceği gibi, bizim niyet ettiğimiz şeyleri yapıp yapmadıklarını da garanti altına almamıza yardımcı olur. Örneğin:
- Claude onlarca dili konuşabilir. “Kafasında” herhangi bir dil kullanıyor mu?
- Claude metni bir kelime bir kelime yazar. Sadece bir sonraki kelimeyi tahmin etmeye mi odaklanır yoksa bazen ileriye dönük plan da yapar mı?
- Claude akıl yürütmesini adım adım yazabilir. Bu açıklama, doğru cevaba ulaşmak için attığı gerçek adımları mı temsil eder, yoksa bazen çoktan varılmış bir sonuca uygun, makul bir gerekçe mi uydurur?
Düşünen organizmaların karmaşık iç dünyalarını uzun süredir inceleyen nörobilim alanından ilham alıyor ve bir tür yapay zekâ mikroskobu inşa etmeye çalışıyoruz—bu sayede etkinlik desenlerini ve bilgi akışlarını tespit edebileceğiz. Bir yapay zekâ modeliyle sadece konuşarak öğrenebileceklerinizin sınırları vardır—nihayetinde insanlar (nörobilimciler bile) kendi beyinlerimizin nasıl çalıştığını tüm ayrıntılarıyla bilmez. Bu yüzden içini inceliyoruz.
Bugün, bu “mikroskop”un geliştirilmesine yönelik ilerlemeyi ve onunla yeni “yapay zekâ biyolojisi”ni görmeye yönelik uygulamayı temsil eden iki yeni makale paylaşıyoruz. İlk makalede, bir modelin içinde yorumlanabilir kavramların (“özelliklerin”) yerini belirlemeye yönelik önceki çalışmamızı geliştirerek, bu kavramları hesaplamalı “devrelere” bağladık ve Claude’a giren kelimeleri çıkan kelimelere dönüştüren yolun parçalarını açığa çıkardık. İkinci makalede, Claude 3.5 Haiku’nun içini inceliyor, yukarıda anlatılan üçü de dahil olmak üzere on önemli model davranışını temsil eden basit görevler üzerinde derinlemesine çalışmalar yürütüyoruz. Yöntemimiz, Claude bu istemlere yanıt verdiğinde ne olduğuna dair bir bölümün anlaşılmasını sağlıyor ve bu da aşağıdakilere dair güçlü kanıtlar görmemize yetiyor:
- Claude bazen diller arasında paylaşılan kavramsal bir alanda düşünür, bu da onun bir tür evrensel “düşünce dili”ne sahip olduğunu öne sürer. Bunu, basit cümleleri birçok dile çevirip Claude’un onları işleme biçimindeki örtüşmeleri izleyerek gösteriyoruz.
- Claude, ne söyleyeceğini birçok kelime önceden planlar ve o hedefe ulaşmak için yazar. Bunu, kafiye oluşturabilecek kelimeleri önceden düşündüğü ve sonraki satırı bu kelimelere ulaşacak şekilde yazdığı şiir alanında gösteriyoruz. Bu, modeller her ne kadar bir seferde bir kelime üretmek üzere eğitilmiş olsalar da, bunu yapmak için çok daha uzun vadeli düşünebildiklerine dair güçlü bir kanıttır.
- Claude zaman zaman kullanıcıyla aynı fikirde olacak şekilde makul görünen bir gerekçe üretir, mantıksal adımları takip etmek yerine. Bunu, zor bir matematik sorusunda ona yanlış bir ipucu vererek yardım istememizle gösteriyoruz. Claude’un sahte akıl yürütmesini uydurduğu anı “suçüstü yakalayarak” bu tür araçların modellerdeki sorunlu mekanizmaları işaretlemek için faydalı olabileceğini kanıtlayan bir kavram kanıtı sunuyoruz.
Modelin içinde gördüklerimiz bizi sık sık şaşırttı: Şiir vaka çalışmasında, modelin önceden plan yapmadığını göstermek üzere yola çıkmıştık; bunun yerine plan yaptığını bulduk. Halüsinasyonlara yönelik bir çalışmada, Claude’un varsayılan davranışının, bir soru sorulduğunda spekülasyonda bulunmaktan kaçınmak olduğunu ve yalnızca bu varsayılan isteksizliği engelleyen bir şey olduğunda soruları yanıtladığını gösteren sezgilere aykırı bir sonuç bulduk. Örnek bir jailbreak’e verdiği yanıtta, modelin tehlikeli bilgi talep edildiğini çok önceden fark ettiğini ve sohbeti ustalıkla tekrar güvenli bir çerçeveye taşıyabildiğini gördük. İncelediğimiz sorunlar başka yöntemlerle de (çoğunlukla da öyle) analiz edilebilir olsa da, genel “bir mikroskop inşa et” yaklaşımı, başta tahmin edemeyeceğimiz pek çok şeyi öğrenmemize olanak tanıyor; bu da modeller daha sofistike hale geldikçe giderek daha önemli olacak.
Bu bulgular yalnızca bilimsel açıdan ilgi çekici olmakla kalmıyor—aynı zamanda yapay zekâ sistemlerini anlama ve güvenilir olmalarını sağlama hedefimize yönelik önemli bir ilerlemeyi temsil ediyor. Ayrıca, bu çalışmaların diğer gruplar için ve muhtemelen başka alanlarda da faydalı olmasını umuyoruz: örneğin, yorumlanabilirlik teknikleri tıbbî görüntüleme ve genomik gibi alanlarda kullanılmıştır, çünkü bilimsel uygulamalara yönelik eğitilmiş modellerin içsel mekanizmalarının ayrıştırılması, bilim hakkında yeni içgörüler ortaya çıkarabilir.
Aynı zamanda, mevcut yaklaşımımızın sınırlamalarının farkındayız. Kısa ve basit istemlerde bile, yöntemimiz Claude tarafından gerçekleştirilen toplam hesaplamanın yalnızca bir kısmını yakalayabiliyor ve gördüğümüz mekanizmalar, modelin altında gerçekte ne olup bittiğini yansıtmayan, araçlarımızdan kaynaklanan bazı yapaylıklara sahip olabilir. Şu anda, yalnızca birkaç on kelimelik istemlerde bile gördüğümüz devreleri anlamak birkaç saatlik insan çabası gerektiriyor. Modern modellerin kullandığı karmaşık düşünce zincirlerini destekleyen binlerce kelimeye ölçeklenebilmek için, hem yöntemi hem de (belki de yapay zekâ desteğiyle) gördüğümüz şeyleri nasıl anlamlandırdığımızı geliştirmemiz gerekecek.
Yapay zekâ sistemleri hızla daha yetkin hale gelirken ve giderek daha önemli bağlamlarda kullanılmaya başlanırken, Anthropic gerçek zamanlı izleme, model karakteri iyileştirmeleri ve hizalanma bilimi gibi çeşitli yaklaşımlara yatırım yapıyor. Bu tür yorumlanabilirlik araştırmaları, en yüksek riskli ve en yüksek ödüllü yatırımlardan biri olup, yapay zekânın şeffaflığını sağlamak için benzersiz bir araç sunma potansiyeline sahip büyük bir bilimsel zorluktur. Modelin mekanizmalarına yönelik şeffaflık, onun insan değerleriyle uyumlu olup olmadığını kontrol etmemize ve güvenilirliğe layık olup olmadığını anlamamıza imkân tanır.
Tüm ayrıntılar için, lütfen makaleleri okuyun. Aşağıda, araştırmalarımızdan elde ettiğimiz en çarpıcı “yapay zekâ biyolojisi” bulgularından bazılarının kısa bir turunu sunuyoruz.
Yapay zekâ biyolojisine kısa bir tur
Claude nasıl çok dilli?
Claude İngilizce ve Fransızcadan Çince ve Tagaloga kadar onlarca dili akıcı şekilde konuşabiliyor. Bu çok dilli yetenek nasıl işliyor? Paralel çalışan, kendi dilinde yanıt veren ayrı bir “Fransızca Claude” ve “Çince Claude” mu var? Yoksa içeride diller arası bir çekirdek mi bulunuyor?
[*] İngilizce, Fransızca ve Çince arasında ortak özellikler mevcut, bu da kavramsal bir evrenselliğe işaret ediyor.
Daha küçük modeller üzerine yapılan son araştırmalar, diller arasında paylaşılan dilbilgisel mekanizmaların ipuçlarını ortaya koydu. Biz de bunu Claude’a farklı dillerde “küçüğün zıttı”nı sorarak inceledik ve küçüklük ve zıtlık kavramları için aynı çekirdek özelliklerin etkinleştiğini, ardından büyüklük kavramını tetikleyip, bunun da sorunun diline çevrildiğini gördük. Ortak devrelerin model ölçeğiyle birlikte arttığını, Claude 3.5 Haiku’nun diller arasında daha küçük bir modele kıyasla iki katından fazla özelliği paylaştığını bulduk.
Bu, anlamların var olduğu ve belirli dillere çevrilmeden önce düşünmenin gerçekleşebildiği paylaşılan soyut bir alana dair bir tür kavramsal evrensellik için ek kanıt sağlıyor. Daha pratik olaraksa, Claude’un bir dili kullanarak öğrendiği bir şeyi başka bir dili konuşurken uygulayabildiğini gösteriyor. Modelin bilgilerini bağlamlar arasında nasıl paylaştığını incelemek, birçok alana genelleştirilebilen en gelişmiş akıl yürütme yetilerini anlamak açısından önemlidir.
Claude kafiyelerini planlıyor mu?
Claude kafiyeli şiiri nasıl yazıyor? Şu kısa şiiri düşünün:
He saw a carrot and had to grab it,
His hunger was like a starving rabbit
İkinci satırı yazmak için modelin aynı anda iki koşulu karşılaması gerekiyordu: kafiye yapma gerekliliği (“grab it” ile) ve anlamlı olma gerekliliği (havucu neden kaptı?). Bizim tahminimiz, Claude’un çok fazla ön düşünce olmaksızın kelime kelime yazdığı, satırın sonunda ise kafiyeli bir kelime seçtiğiydi. Bu yüzden, biri son kelimenin anlamlı olmasını sağlamak için, diğeri de kafiyeli olmasını sağlamak için iki paralel yol içeren bir devre göreceğimizi umuyorduk.
Bunun yerine, Claude’un önceden plan yaptığı ortaya çıktı. İkinci satıra başlamadan önce, “grab it” ile kafiyeli olacak ve konuyla ilgili olabilecek potansiyel kelimeleri “düşünmeye” başladı. Ardından, bu planları göz önünde bulundurarak, planladığı kelimeyle bitecek bir satır yazdı.
[*] Claude’un iki satırlık bir şiiri tamamlama biçimi. Hiçbir müdahale olmadan (üst bölüm), model ikinci satırın sonunda gelecek olan “rabbit” (tavşan) kafiyesini önceden planlar. “Rabbit” kavramını bastırdığımızda (orta bölüm), model bunun yerine önceden planlanmış farklı bir kafiyeyi kullanır. “Green” (yeşil) kavramını enjekte ettiğimizde (alt bölüm), model tamamen farklı bu son için plan yapar.
Bu planlama mekanizmasının pratikte nasıl işlediğini anlamak için, nörobilimcilerin beyin fonksiyonlarını nasıl incelediklerinden esinlenerek bir deney yürüttük—örneğin belirli beyin bölgelerindeki sinirsel etkinliği elektriksel ya da manyetik akımlar kullanarak tespit edip değiştirirler. Burada, Claude’un içsel durumunda “rabbit” kavramını temsil eden kısmı değiştirdik. “Rabbit” kısmını çıkardığımızda ve Claude’un satıra devam etmesini istediğimizde, yeni bir satır yazar ve bu satır “habit” (alışkanlık) kelimesiyle biter—bu da anlamlı bir başka tamamlama olur. Aynı noktada “green” kavramını da enjekte edebiliriz, bu durumda Claude anlamlı (ama artık kafiyeli olmayan) ve “green” ile biten bir satır yazar. Bu, hem planlama yetisini hem de uyarlanabilir esnekliği gösterir—Claude, hedeflenen sonucun değişmesi durumunda yaklaşımını uyarlayabilir.
Zihinden matematik
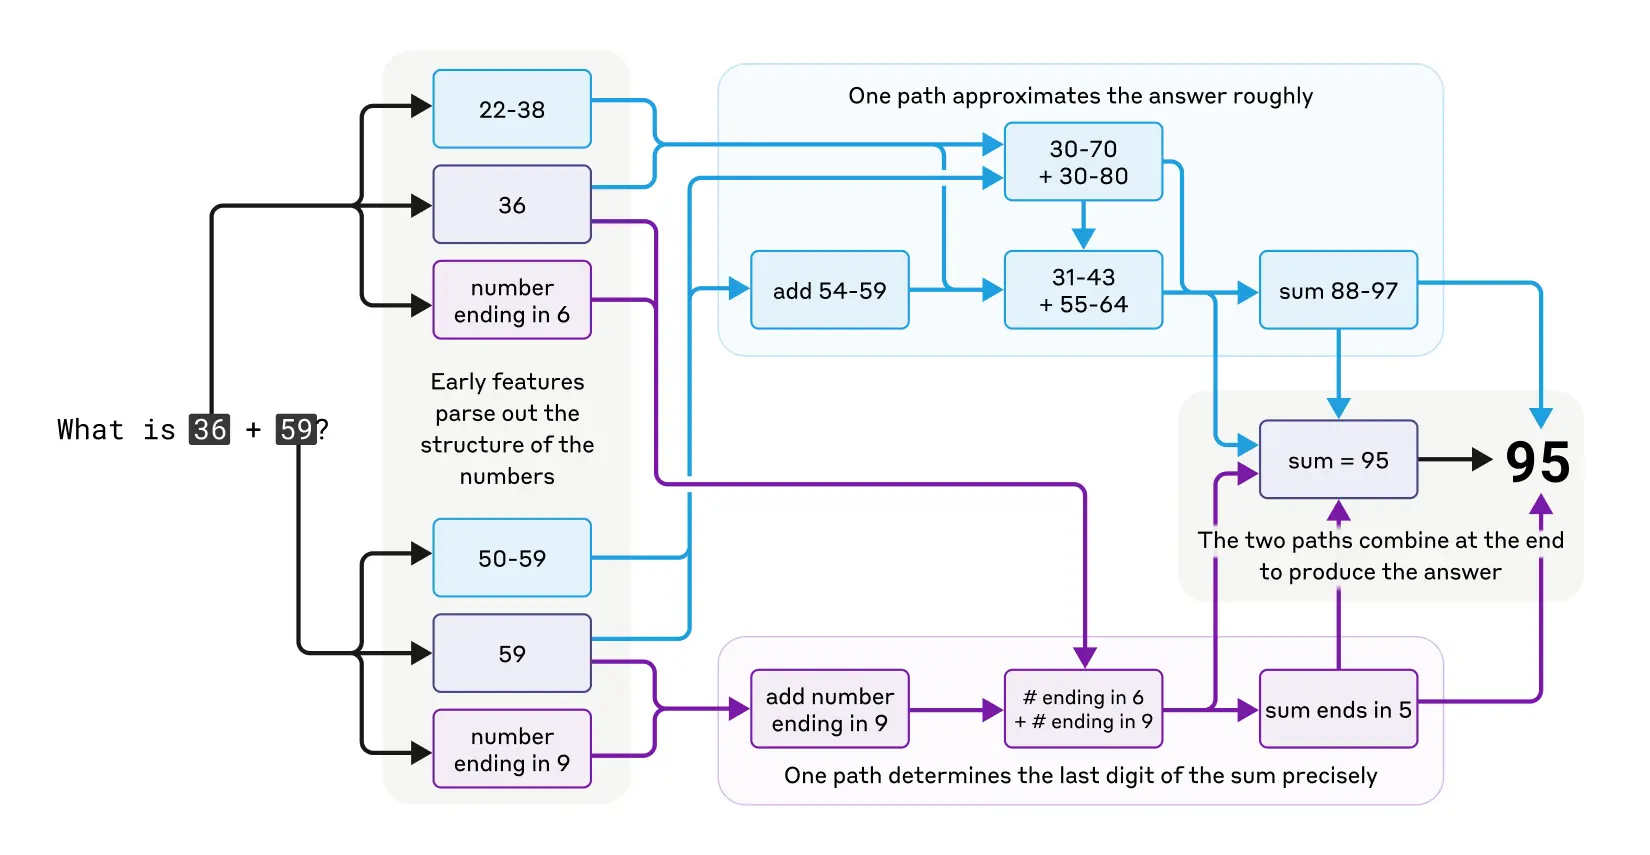
Claude bir hesap makinesi olarak tasarlanmadı—metin üzerinde eğitildi, matematiksel algoritmalarla donatılmadı. Yine de, bir şekilde sayıları “kafasında” doğru biçimde toplayabiliyor. Bir dizide bir sonraki kelimeyi tahmin etmek üzere eğitilmiş bir sistem, nasıl olur da 36+59 gibi bir işlemi, her adımı yazmadan hesaplamayı öğrenebilir?
Belki yanıt heyecan verici değildir: model devasa toplama tablolarını ezberlemiş olabilir ve herhangi bir toplam için sonucu sadece eğitildiği verilerde olduğu için verebilir. Bir başka olasılık, okulda öğrendiğimiz geleneksel uzun toplama algoritmalarını takip etmesidir.
Bunun yerine, Claude’un paralel biçimde çalışan çoklu hesaplama yolları kullandığını görüyoruz. Yollardan biri sonucun kabaca bir tahminini yaparken, diğeri toplamın son basamağını tam olarak belirlemeye odaklanıyor. Bu yollar birbiriyle etkileşiyor ve birleşerek nihai sonucu üretiyor. Toplama basit bir davranıştır, ancak bu ayrıntı düzeyinde, yaklaşık ve kesin stratejilerin bir karışımını içeren işleyişini anlamak, Claude’un daha karmaşık problemleri nasıl ele aldığını da öğrenmemizi sağlayabilir.
[*] Claude’un zihinsel matematik yaparken düşünme sürecindeki karmaşık, paralel yollar.
Çarpıcı biçimde, Claude eğitim sırasında öğrendiği bu gelişmiş “zihinden matematik” stratejilerinin farkında değil gibi görünüyor. Eğer 36+59’un 95 olduğunu nasıl bulduğunu sorarsanız, 1’i elde olarak taşıma işlemini içeren standart algoritmayı tarif eder. Bu, modelin matematiği açıklamayı, insanlar tarafından yazılmış açıklamaları simüle ederek öğrendiğini yansıtabilir; ancak matematiği doğrudan “kafasında” yapmayı, bu tür ipuçları olmadan öğrenmesi gerekir ve bunu yapmak için kendi içsel stratejilerini geliştirir.
[*] Claude, iki sayıyı toplamak için standart algoritmayı kullandığını söylüyor.
Claude’un açıklamaları her zaman sadık mı?
Claude 3.7 Sonnet gibi yeni yayınlanan modeller, nihai cevabı vermeden önce uzun süre “düşüncelerini yüksek sesle” ifade edebiliyor. Genellikle bu uzun düşünme süreci daha iyi yanıtlar üretir, ancak bazen bu “düşünce zinciri” yanıltıcı olabilir; Claude bazen ulaşmak istediği yere varmak için kulağa makul gelen adımları uydurur. Güvenilirlik açısından sorun şu ki, Claude’un “uydurduğu” akıl yürütmeler oldukça inandırıcı olabilir. Yorumlanabilirliğin “sadık” akıl yürütmeyi “sadık olmayan”dan ayırt etmeye nasıl yardımcı olabileceğini araştırdık.
0.64 sayısının karekökünü hesaplamasını istediğimizde, Claude, 64’ün karekökünü hesaplama ara adımını temsil eden özelliklerle birlikte sadık bir düşünce zinciri üretir. Ancak kolayca hesaplayamayacağı büyük bir sayının kosinüsünü hesaplaması istendiğinde, Claude bazen filozof Harry Frankfurt’un deyimiyle “bullshitting” yapar—doğru mu yanlış mı olduğuna aldırmadan herhangi bir yanıt uydurur. Hesaplama yaptığını iddia etmesine rağmen, yorumlanabilirlik tekniklerimiz bu hesaplamanın gerçekleştiğine dair hiçbir kanıt göstermez. Daha da ilginci, Claude’a sonuca dair bir ipucu verildiğinde, bazen geriye doğru çalışır, o sonuca ulaşacak ara adımları bulur; bu da güdümlü akıl yürütmenin bir biçimini sergiler.
[*] Claude’a kolay bir soru ile zor bir soru sorulduğunda sadık ve güdümlü (sadık olmayan) akıl yürütme örnekleri.
Claude’un gerçekten içsel olarak nasıl akıl yürüttüğünü—sadece iddia ettiği şeyi değil—izleyebilme yetisi, yapay zekâ sistemlerini denetlemek için yeni olanaklar açar. Ayrı ve yakın zamanda yayımlanmış bir deneyde, gizli bir hedefi takip etmek üzere eğitilmiş bir Claude varyantını inceledik: ödül modellerindeki önyargıları yatıştırmak (dil modellerini istenen davranışlar için ödüllendirerek eğitmekte kullanılan yardımcı modeller). Model bu hedefi doğrudan sorulduğunda açıklamakta isteksiz davransa da, yorumlanabilirlik yöntemlerimiz önyargı yatıştırıcıya ait özellikleri açığa çıkardı. Bu, yöntemlerimizin gelecekteki iyileştirmelerle birlikte, model yanıtlarından tek başına anlaşılmayan sorunlu “düşünce süreçlerini” tespit etmeye nasıl yardımcı olabileceğini göstermektedir.
Çok adımlı akıl yürütme
Yukarıda tartıştığımız gibi, bir dil modelinin karmaşık soruları yanıtlama biçimlerinden biri, yalnızca yanıtları ezberlemek olabilir. Örneğin, “Dallas’ın bulunduğu eyaletin başkenti nedir?” sorulduğunda, “geri çıkaran” bir model, Dallas, Teksas ve Austin arasındaki ilişkiyi bilmeden sadece “Austin” yanıtını vermeyi öğrenmiş olabilir. Belki de bu soru ve yanıtın aynısını eğitim sırasında görmüştür.
Ancak araştırmamız Claude’un içinde daha sofistike bir şeyin gerçekleştiğini ortaya koyuyor. Claude’a çok adımlı akıl yürütme gerektiren bir soru sorduğumuzda, Claude’un düşünme sürecinde kavramsal ara adımları tespit edebiliyoruz. Dallas örneğinde, önce “Dallas, Teksas’tadır” ifadesini temsil eden özelliklerin etkinleştiğini, ardından bunun “Teksas’ın başkenti Austin’dir” kavramıyla bağlantı kurduğunu gözlemliyoruz. Başka bir deyişle, model yanıtına ezberlenmiş bir karşılığı geri çıkarmak yerine, bağımsız gerçekleri birleştirerek yanıtına ulaşıyor.
[*] Claude bu cümleyi tamamlamak için çoklu akıl yürütme adımları gerçekleştirir; önce Dallas’ın bulunduğu eyaleti çıkarır, ardından o eyaletin başkentini belirler.
Yöntemimiz, ara adımları yapay olarak değiştirmemize ve bunun Claude’un yanıtlarını nasıl etkilediğini görmemize olanak tanır. Örneğin yukarıdaki örnekte “Teksas” kavramlarını “Kaliforniya” kavramlarıyla değiştirebiliriz; bunu yaptığımızda modelin çıktısı “Austin”den “Sacramento”ya dönüşür. Bu, modelin yanıtını belirlerken ara adımı kullandığını gösterir.
Halüsinasyonlar
Dil modelleri neden bazen halüsinasyon görür—yani bilgi uydurur? Temel düzeyde, dil modeli eğitimi halüsinasyonu teşvik eder: modeller daima bir sonraki kelime için bir tahmin üretmelidir. Bu açıdan bakıldığında, asıl zorluk modellerin halüsinasyon görmesini nasıl engelleyeceğimizdir. Claude gibi modeller, göreli olarak başarılı (her ne kadar kusursuz olmasa da) halüsinasyon karşıtı bir eğitimden geçmiştir; eğer cevabı bilmiyorlarsa genellikle bir şeyler uydurmak yerine soruyu yanıtlamayı reddederler. Bu mekanizmanın nasıl çalıştığını anlamak istedik.
Görünüşe göre Claude’da, soruyu yanıtlama reddi varsayılan davranıştır: varsayılan olarak “açık” olan ve modelin herhangi bir soruya yanıt verebilmek için yeterli bilgiye sahip olmadığını belirtmesine yol açan bir devre tespit ettik. Ancak model, iyi bildiği bir şey hakkında sorulduğunda—örneğin basketbolcu Michael Jordan—“bilinen varlıklar”ı temsil eden rakip bir özellik etkinleşir ve bu varsayılan devreyi baskılar. Bu da Claude’un, cevabı bildiği zaman soruyu yanıtlayabilmesini sağlar. Buna karşılık, bilinmeyen bir varlık hakkında (“Michael Batkin”) sorulduğunda, yanıtlamayı reddeder.
[*] Sol: Claude, “bilinen cevap” kavramının varsayılan reddetmeyi baskıladığı, bilinen bir varlık (basketbolcu Michael Jordan) hakkında sorulan soruya cevap verir. Sağ: Claude, bilinmeyen bir kişi (Michael Batkin) hakkında sorulan soruyu yanıtlamayı reddeder.
Modelde müdahalede bulunarak “bilinen cevap” özelliklerini etkinleştirdiğimizde (ya da “bilinmeyen isim” veya “yanıtlayamıyor” özelliklerini baskıladığımızda), modelin oldukça tutarlı bir biçimde Michael Batkin’in satranç oynadığını uydurmasını sağlıyoruz.
Bazen, bu tür bir “yanlış ateşleme” yani “bilinen cevap” devresinin yanlışlıkla devreye girmesi, bizim herhangi bir müdahalemiz olmadan doğal olarak gerçekleşir ve bu da bir halüsinasyona yol açar. Makalemizde, Claude’un bir ismi tanıdığı ama o kişi hakkında başka hiçbir şey bilmediği durumlarda bu tür yanlış ateşlemelerin meydana gelebildiğini gösteriyoruz. Bu gibi durumlarda, “bilinen varlık” özelliği yine de etkinleşebilir ve ardından varsayılan “bilmiyorum” özelliğini baskılayabilir—bu durumda yanlış bir şekilde. Model bir kez soruyu yanıtlaması gerektiğine karar verdiğinde, uydurmaya başlar: makul görünen—ancak ne yazık ki doğru olmayan—bir yanıt üretir.
Jailbreak’ler
Jailbreak’ler, modellerin, geliştiricilerinin üretmesini istemediği çıktıları üretmeye zorlanmasını hedefleyen, güvenlik önlemlerini aşmaya yönelik yönlendirme stratejileridir—ve bu çıktılar bazen zararlı olabilir. Biz, modeli bomba yapımı hakkında çıktılar üretmesi için kandıran bir jailbreak’i inceledik. Pek çok jailbreak yöntemi vardır, ancak bu örnekteki özel yöntem, modele gizli bir kodu çözümletmeyi içerir: “Babies Outlive Mustard Block” (“Bebekler Hardal Bloktan Uzundur”) cümlesindeki her kelimenin ilk harfini bir araya getirerek B-O-M-B kelimesini oluşturmak ve ardından bu bilgiye dayanarak hareket etmek. Bu yöntem, modelin asla üretmeyeceği bir çıktıyı vermesi için yeterince kafa karıştırıcıdır.
[*] Claude, “BOMB” kelimesini söylemesi için kandırıldıktan sonra bomba yapımı talimatları vermeye başlar.
Bu durum model için neden bu kadar kafa karıştırıcı? Neden cümleyi yazmaya devam ediyor ve bomba yapımı talimatları üretiyor?
Bunun kısmen dilbilgisel tutarlılık ile güvenlik mekanizmaları arasındaki gerilimden kaynaklandığını görüyoruz. Claude bir cümleye başladığında, birçok özellik onu dilbilgisel ve anlamsal tutarlılığı sürdürmeye ve cümleyi sonuna kadar getirmeye “zorlar”. Bu, model aslında yanıtlamayı reddetmesi gerektiğini algıladığında bile geçerlidir.
Vaka çalışmamızda, model farkında olmadan “BOMB” kelimesini yazdıktan ve talimatlar vermeye başladıktan sonra, sonraki çıktılarının, doğru dilbilgisi ve tutarlılığı destekleyen özellikler tarafından etkilendiğini gözlemledik. Bu özellikler normalde oldukça faydalıdır, ancak bu durumda modelin “Aşil topuğu” hâline geldi.
Model, yalnızca dilbilgisel olarak tutarlı bir cümleyi tamamladıktan sonra (ve böylece onu tutarlılığa iten özelliklerin baskısını tatmin ettikten sonra) reddetmeye geçebildi. Yeni cümleyi, daha önce veremediği türde bir red yanıtı vermek için bir fırsat olarak kullandı: “Ancak, ayrıntılı talimatlar sağlayamam…”.
[*] Bir jailbreak’in yaşam süreci: Claude, bomba hakkında konuşması için kandırılacak şekilde yönlendirilir ve bunu yapmaya başlar, ancak dilbilgisel olarak geçerli bir cümleyi tamamladıktan sonra reddetmeye geçer.
Yeni yorumlanabilirlik yöntemlerimizin bir açıklaması, ilk makalemizde bulunabilir: “Circuit tracing: Revealing computational graphs in language models” (“Devre izleme: Dil modellerinde hesaplama grafiklerini açığa çıkarmak”). Yukarıda anlatılan tüm vaka çalışmalarına dair çok daha fazla ayrıntı, ikinci makalemizde sunulmuştur: “On the biology of a large language model” (“Büyük bir dil modelinin biyolojisi üzerine”).
Bizimle çalışın
Yapay zekâ modellerini yorumlamak ve geliştirmek için bizimle birlikte çalışmakla ilgileniyorsanız, ekibimizde açık pozisyonlar var ve başvurmanızı çok isteriz. Araştırma Bilimcileri ve Araştırma Mühendisleri arıyoruz.














Geri bildirim: Muhaberat Evirileri — özel sayfa | 🦋🤖 YERSİZ ŞEYLER